엔비디아 DGX 스파크 64GB, 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행
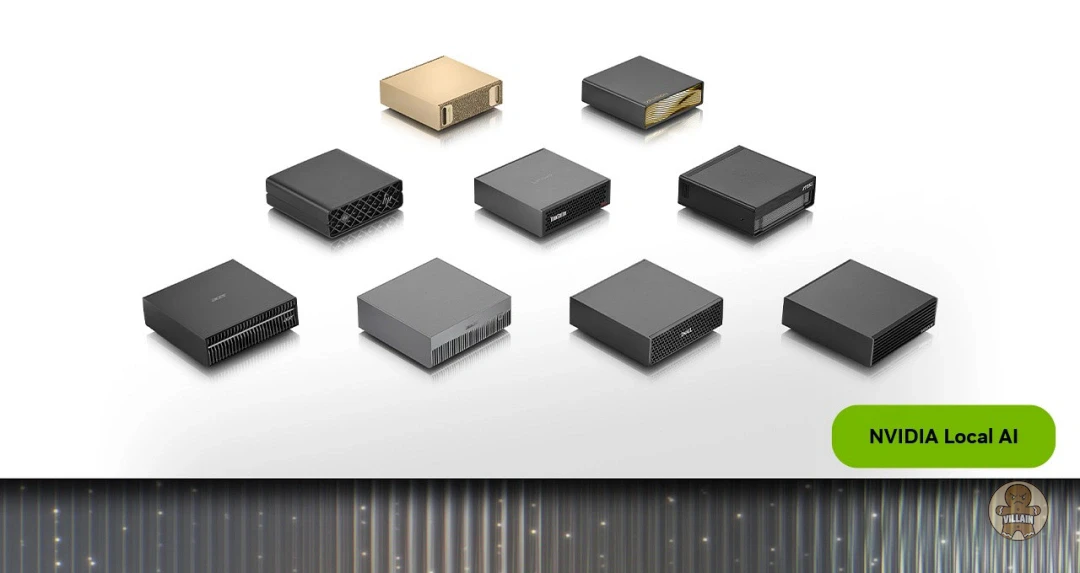
- 10월 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행 - 엔비디아 싱크 클러스터 어시스턴트로 DGX 스파크 연결... 메모리·성능 확장 - 에이전트 개발부터 AI 애플리케이션까지 다양한 로컬 AI 활용 지원 엔비디아(www.nvidia.co.kr)가 컴팩트한 개인용 AI 슈퍼컴퓨터인 엔비디아 DGX 스파크(NVIDIA DGX Spark)의 64GB 구성을 새롭게 공개했다. 로컬 AI는 토큰 단위로 더욱 유용해지고 있다. AI 에이전트가 실험 단계를 넘어 일상적인 개발 환경으로 자리 잡으면서, 더욱 강력해진 오픈 모델은 보다 많은 디바이스에 탑재 가능한 크기로 축소되고 있다. 동시에 로컬에서 실행할 수 있는 선택지도 점점 다양해지고 있다. 엔비디아 DGX 스파크는 10월 중 주요 제조사 파트너인 에이서(Acer), 에이수스(ASUS), 델(Dell), 기가바이트(Gigabyte), HP, MSI를 통해 64GB 통합 메모리 구성으로 출시된다. 개발자, 연구자, AI 애호가들은 새로운 64GB 구성을 통해 DGX OS와 엔비디아 AI 소프트웨어 스택을 바로 활용할 수 있다. DGX 스파크 64GB는 디바이스에서 로컬 에이전트를 실행할 수 있어 클라우드에 의존하지 않고도 자체 처리가 가능하다. 또한 워크로드가 증가하면 엔비디아 싱크 클러스터 어시스턴트(Sync Cluster Assistant)를 통해 별도의 추가 설정 없이 두 대의 시스템을 하나의 클러스터로 연결할 수 있다. 개인용 AI 슈퍼컴퓨팅을 위한 새로운 시작점 DGX 스파크는 엔비디아 그레이스 블랙웰(Grace Blackwell) 컴퓨팅, 통합 메모리, 엔비디아 커넥트X-7(ConnectX-7) 네트워킹, 엔비디아 쿠다(CUDA) 가속 AI 소프트웨어 스택을 하나의 시스템에 결합했다. 이는 에이전트, 추론, 파인튜닝, 데이터 과학, 엣지 개발을 위한 완전한 로컬 AI 플랫폼이다. 컴팩트한 개인용 AI 슈퍼컴퓨터인 DGX 스파크는 모든 작업에서 클라우드 인스턴스를 사용할 필요 없이 개발자가 자신의 데이터로 모델을 실험할 수 있는 환경을 제공한다. 새로운 64GB 구성은 주요 제조사 파트너를 통해 제공되며, 도입 부담을 낮춘 가격대로 제공된다. 기존 128GB 모델과 동일한 GB10 그레이스 블랙웰 슈퍼칩(Grace Blackwell Superchip), DGX OS, 전체 엔비디아 AI 소프트웨어 스택을 그대로 제공하며, 최대 1,000억 파라미터 모델과 이를 기반으로 구축된 에이전트 애플리케이션을 디바이스에서 완전히 실행할 수 있다. 64GB 시스템 두 대를 클러스터로 연결하면 메모리와 성능을 함께 확장할 수 있다. 엔비디아가 자체적으로 진행한 큐원(Qwen) 3.8 27B 테스트에서 두 시스템을 클러스터로 구성했을 때 단일 시스템 대비 최대 1.7배의 성능을 기록했다. 또한 워크로드 요구에 따른 추가 확장도 가능하다. DGX 스파크는 에이전트 개발에 필요한 환경을 갖췄다. 엔비디아 에이전트 툴킷(Agent Toolkit), 쿠다-X(CUDA-X) AI 라이브러리, 네모트론(Nemotron) 오픈 모델과 올라마(Ollama), vLLM, 쿠다 지원 파이토치(PyTorch) 등 주요 런타임을 기본 지원한다. 개발자는 전원을 켠 후 몇 분 만에 모델을 실행할 수 있다. 블렌더(Blender)는 이 플랫폼을 지원하는 최초의 주요 크리에이터 애플리케이션 중 하나로, 사전 구성된 설치 프로그램이 곧 제공될 예정이다. 엔비디아 싱크 클러스터 어시스턴트로 손쉽게 확장 개발자는 현재 프로젝트에 필요한 메모리로 시작해, 파이프라인이 확장됨에 따라 커진 워크로드에 맞춰 멀티 노드 클러스터로 원활하게 확장할 수 있다. 모든 DGX 스파크에는 엔비디아 커넥트X-7 NIC가 기본 탑재된다. 이와 함께 두 대의 시스템을 QSFP 케이블로 직접 연결해 메모리를 128GB로 확장하고, 최대 2,000억 파라미터 모델까지 지원 범위를 확장할 수 있다. 동시에 메모리 대역폭을 두 배로 늘리고 최대 1.7배의 성능을 활용할 수 있다. 엔비디아 싱크(Sync) 앱은 간편한 멀티 노드 클러스터 구성을 지원한다. 클러스터 어시스턴트 기능은 연결된 시스템을 감지하고, 디바이스 구성을 검증하며, 커넥트X-7 네트워크를 구성해 개발자가 인프라보다 작업 자체에 집중할 수 있도록 한다. 모든 노드는 동일한 엔비디아 소프트웨어 스택을 활용하므로, 한 대에서 두 대로 확장할 때 소프트웨어를 다시 구성할 필요가 없다. 한편 이달 말부터 엔비디아 싱크 모델 런처(Sync Model Launcher)를 통해 몇 번의 클릭만으로 로컬 AI를 간편하게 실행할 수 있다. 개발자는 단일 DGX 스파크 시스템 또는 클러스터에서 큐원 3.8 27B를 다운로드하고 실행할 수 있으며, 엔비디아 싱크가 연결된 디바이스에서 모델이 실행되도록 구성해 노트북에서도 해당 모델에 접근할 수 있다. 아울러 런처는 오픈코드(OpenCode)가 해당 모델을 사용할 수 있도록 설정해, 개발자가 브라우저에서 바로 코딩을 시작할 수 있도록 지원한다. DGX 스파크 개발자 활용 사례 새로운 DGX 스파크 64GB는 최대 1,000억 파라미터 모델을 디바이스에서 완전히 실행할 수 있어 다양한 작업에 활용할 수 있다. 개발자와 AI 애호가는 메모리 용량에 맞는 모델을 단일 시스템에서 실행할 수 있으며, 더 많은 메모리와 컴퓨팅이 필요한 워크로드의 경우 엔비디아 싱크 클러스터 어시스턴트를 통해 여러 대의 DGX 스파크를 연결할 수 있다. 다음은 세 가지 주요 워크플로우 예시다: - AI 에이전트 24시간 실행: DGX 스파크에서 코딩 또는 연구용 에이전트를 실행해 코드를 검토하고, 문서를 분석하거나, 여러 단계의 작업을 수행할 수 있다. 클러스터를 구성하면 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 동시에 작동하는 여러 에이전트를 위한 추가 용량을 확보할 수 있다. - 일상적으로 활용하는 PC에서 AI 애플리케이션 구동: 노트북이나 데스크톱에서 에이전트 또는 크리에이티브 애플리케이션을 사용하는 동시에 DGX 스파크에서 언어 또는 이미지 생성 모델을 실행할 수 있다. DGX 스파크가 모델 추론을 처리하는 동안 PC에서는 다른 작업을 수행할 수 있다. - 워크로드 증가에 따른 확장: 하나의 작업이 단일 시스템의 처리 범위를 넘어 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 여러 에이전트 요청을 동시에 처리해야 하는 경우, 엔비디아 싱크 클러스터 어시스턴트를 활용할 수 있다. 200 GbE 패브릭으로 연결된 두 대의 DGX 스파크 64GB 시스템은 메모리를 128GB로 통합하며, 소프트웨어 환경을 재구성할 필요 없이 한 대에서 실행하던 워크플로우를 두 대로 확장할 수 있다. DGX 스파크 시작하기 DGX 스파크 64GB는 10월 23일(현지 시간)을 시작으로 에이서, 에이수스, 델, 기가바이트, HP, MSI를 통해 4,999달러부터 구매할 수 있다. @nvidia @msi @gigabyte @acer
- NVIDIADGXXSpark
- 개인AI슈퍼컴퓨터
- 로컬AI
- AI개발
 5
 6
 에이서
@acer
PC/주변기기
|
26-10-06
엔비디아 DGX 스파크 64GB, 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행
- 10월 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행 - 엔비디아 싱크 클러스터 어시스턴트로 DGX 스파크 연결... 메모리·성능 확장 - 에이전트 개발부터 AI 애플리케이션까지 다양한 로컬 AI 활용 지원 엔비디아(www.nvidia.co.kr)가 컴팩트한 개인용 AI 슈퍼컴퓨터인 엔비디아 DGX 스파크(NVIDIA DGX Spark)의 64GB 구성을 새롭게 공개했다. 로컬 AI는 토큰 단위로 더욱 유용해지고 있다. AI 에이전트가 실험 단계를 넘어 일상적인 개발 환경으로 자리 잡으면서, 더욱 강력해진 오픈 모델은 보다 많은 디바이스에 탑재 가능한 크기로 축소되고 있다. 동시에 로컬에서 실행할 수 있는 선택지도 점점 다양해지고 있다. 엔비디아 DGX 스파크는 10월 중 주요 제조사 파트너인 에이서(Acer), 에이수스(ASUS), 델(Dell), 기가바이트(Gigabyte), HP, MSI를 통해 64GB 통합 메모리 구성으로 출시된다. 개발자, 연구자, AI 애호가들은 새로운 64GB 구성을 통해 DGX OS와 엔비디아 AI 소프트웨어 스택을 바로 활용할 수 있다. DGX 스파크 64GB는 디바이스에서 로컬 에이전트를 실행할 수 있어 클라우드에 의존하지 않고도 자체 처리가 가능하다. 또한 워크로드가 증가하면 엔비디아 싱크 클러스터 어시스턴트(Sync Cluster Assistant)를 통해 별도의 추가 설정 없이 두 대의 시스템을 하나의 클러스터로 연결할 수 있다. 개인용 AI 슈퍼컴퓨팅을 위한 새로운 시작점 DGX 스파크는 엔비디아 그레이스 블랙웰(Grace Blackwell) 컴퓨팅, 통합 메모리, 엔비디아 커넥트X-7(ConnectX-7) 네트워킹, 엔비디아 쿠다(CUDA) 가속 AI 소프트웨어 스택을 하나의 시스템에 결합했다. 이는 에이전트, 추론, 파인튜닝, 데이터 과학, 엣지 개발을 위한 완전한 로컬 AI 플랫폼이다. 컴팩트한 개인용 AI 슈퍼컴퓨터인 DGX 스파크는 모든 작업에서 클라우드 인스턴스를 사용할 필요 없이 개발자가 자신의 데이터로 모델을 실험할 수 있는 환경을 제공한다. 새로운 64GB 구성은 주요 제조사 파트너를 통해 제공되며, 도입 부담을 낮춘 가격대로 제공된다. 기존 128GB 모델과 동일한 GB10 그레이스 블랙웰 슈퍼칩(Grace Blackwell Superchip), DGX OS, 전체 엔비디아 AI 소프트웨어 스택을 그대로 제공하며, 최대 1,000억 파라미터 모델과 이를 기반으로 구축된 에이전트 애플리케이션을 디바이스에서 완전히 실행할 수 있다. 64GB 시스템 두 대를 클러스터로 연결하면 메모리와 성능을 함께 확장할 수 있다. 엔비디아가 자체적으로 진행한 큐원(Qwen) 3.8 27B 테스트에서 두 시스템을 클러스터로 구성했을 때 단일 시스템 대비 최대 1.7배의 성능을 기록했다. 또한 워크로드 요구에 따른 추가 확장도 가능하다. DGX 스파크는 에이전트 개발에 필요한 환경을 갖췄다. 엔비디아 에이전트 툴킷(Agent Toolkit), 쿠다-X(CUDA-X) AI 라이브러리, 네모트론(Nemotron) 오픈 모델과 올라마(Ollama), vLLM, 쿠다 지원 파이토치(PyTorch) 등 주요 런타임을 기본 지원한다. 개발자는 전원을 켠 후 몇 분 만에 모델을 실행할 수 있다. 블렌더(Blender)는 이 플랫폼을 지원하는 최초의 주요 크리에이터 애플리케이션 중 하나로, 사전 구성된 설치 프로그램이 곧 제공될 예정이다. 엔비디아 싱크 클러스터 어시스턴트로 손쉽게 확장 개발자는 현재 프로젝트에 필요한 메모리로 시작해, 파이프라인이 확장됨에 따라 커진 워크로드에 맞춰 멀티 노드 클러스터로 원활하게 확장할 수 있다. 모든 DGX 스파크에는 엔비디아 커넥트X-7 NIC가 기본 탑재된다. 이와 함께 두 대의 시스템을 QSFP 케이블로 직접 연결해 메모리를 128GB로 확장하고, 최대 2,000억 파라미터 모델까지 지원 범위를 확장할 수 있다. 동시에 메모리 대역폭을 두 배로 늘리고 최대 1.7배의 성능을 활용할 수 있다. 엔비디아 싱크(Sync) 앱은 간편한 멀티 노드 클러스터 구성을 지원한다. 클러스터 어시스턴트 기능은 연결된 시스템을 감지하고, 디바이스 구성을 검증하며, 커넥트X-7 네트워크를 구성해 개발자가 인프라보다 작업 자체에 집중할 수 있도록 한다. 모든 노드는 동일한 엔비디아 소프트웨어 스택을 활용하므로, 한 대에서 두 대로 확장할 때 소프트웨어를 다시 구성할 필요가 없다. 한편 이달 말부터 엔비디아 싱크 모델 런처(Sync Model Launcher)를 통해 몇 번의 클릭만으로 로컬 AI를 간편하게 실행할 수 있다. 개발자는 단일 DGX 스파크 시스템 또는 클러스터에서 큐원 3.8 27B를 다운로드하고 실행할 수 있으며, 엔비디아 싱크가 연결된 디바이스에서 모델이 실행되도록 구성해 노트북에서도 해당 모델에 접근할 수 있다. 아울러 런처는 오픈코드(OpenCode)가 해당 모델을 사용할 수 있도록 설정해, 개발자가 브라우저에서 바로 코딩을 시작할 수 있도록 지원한다. DGX 스파크 개발자 활용 사례 새로운 DGX 스파크 64GB는 최대 1,000억 파라미터 모델을 디바이스에서 완전히 실행할 수 있어 다양한 작업에 활용할 수 있다. 개발자와 AI 애호가는 메모리 용량에 맞는 모델을 단일 시스템에서 실행할 수 있으며, 더 많은 메모리와 컴퓨팅이 필요한 워크로드의 경우 엔비디아 싱크 클러스터 어시스턴트를 통해 여러 대의 DGX 스파크를 연결할 수 있다. 다음은 세 가지 주요 워크플로우 예시다: - AI 에이전트 24시간 실행: DGX 스파크에서 코딩 또는 연구용 에이전트를 실행해 코드를 검토하고, 문서를 분석하거나, 여러 단계의 작업을 수행할 수 있다. 클러스터를 구성하면 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 동시에 작동하는 여러 에이전트를 위한 추가 용량을 확보할 수 있다. - 일상적으로 활용하는 PC에서 AI 애플리케이션 구동: 노트북이나 데스크톱에서 에이전트 또는 크리에이티브 애플리케이션을 사용하는 동시에 DGX 스파크에서 언어 또는 이미지 생성 모델을 실행할 수 있다. DGX 스파크가 모델 추론을 처리하는 동안 PC에서는 다른 작업을 수행할 수 있다. - 워크로드 증가에 따른 확장: 하나의 작업이 단일 시스템의 처리 범위를 넘어 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 여러 에이전트 요청을 동시에 처리해야 하는 경우, 엔비디아 싱크 클러스터 어시스턴트를 활용할 수 있다. 200 GbE 패브릭으로 연결된 두 대의 DGX 스파크 64GB 시스템은 메모리를 128GB로 통합하며, 소프트웨어 환경을 재구성할 필요 없이 한 대에서 실행하던 워크플로우를 두 대로 확장할 수 있다. DGX 스파크 시작하기 DGX 스파크 64GB는 10월 23일(현지 시간)을 시작으로 에이서, 에이수스, 델, 기가바이트, HP, MSI를 통해 4,999달러부터 구매할 수 있다. @nvidia @msi @gigabyte @acer
- NVIDIADGXXSpark
- 개인AI슈퍼컴퓨터
- 로컬AI
- AI개발
5
6
 MSI
@msi
PC/주변기기
|
26-10-06
엔비디아 DGX 스파크 64GB, 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행
- 10월 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행 - 엔비디아 싱크 클러스터 어시스턴트로 DGX 스파크 연결... 메모리·성능 확장 - 에이전트 개발부터 AI 애플리케이션까지 다양한 로컬 AI 활용 지원 엔비디아(www.nvidia.co.kr)가 컴팩트한 개인용 AI 슈퍼컴퓨터인 엔비디아 DGX 스파크(NVIDIA DGX Spark)의 64GB 구성을 새롭게 공개했다. 로컬 AI는 토큰 단위로 더욱 유용해지고 있다. AI 에이전트가 실험 단계를 넘어 일상적인 개발 환경으로 자리 잡으면서, 더욱 강력해진 오픈 모델은 보다 많은 디바이스에 탑재 가능한 크기로 축소되고 있다. 동시에 로컬에서 실행할 수 있는 선택지도 점점 다양해지고 있다. 엔비디아 DGX 스파크는 10월 중 주요 제조사 파트너인 에이서(Acer), 에이수스(ASUS), 델(Dell), 기가바이트(Gigabyte), HP, MSI를 통해 64GB 통합 메모리 구성으로 출시된다. 개발자, 연구자, AI 애호가들은 새로운 64GB 구성을 통해 DGX OS와 엔비디아 AI 소프트웨어 스택을 바로 활용할 수 있다. DGX 스파크 64GB는 디바이스에서 로컬 에이전트를 실행할 수 있어 클라우드에 의존하지 않고도 자체 처리가 가능하다. 또한 워크로드가 증가하면 엔비디아 싱크 클러스터 어시스턴트(Sync Cluster Assistant)를 통해 별도의 추가 설정 없이 두 대의 시스템을 하나의 클러스터로 연결할 수 있다. 개인용 AI 슈퍼컴퓨팅을 위한 새로운 시작점 DGX 스파크는 엔비디아 그레이스 블랙웰(Grace Blackwell) 컴퓨팅, 통합 메모리, 엔비디아 커넥트X-7(ConnectX-7) 네트워킹, 엔비디아 쿠다(CUDA) 가속 AI 소프트웨어 스택을 하나의 시스템에 결합했다. 이는 에이전트, 추론, 파인튜닝, 데이터 과학, 엣지 개발을 위한 완전한 로컬 AI 플랫폼이다. 컴팩트한 개인용 AI 슈퍼컴퓨터인 DGX 스파크는 모든 작업에서 클라우드 인스턴스를 사용할 필요 없이 개발자가 자신의 데이터로 모델을 실험할 수 있는 환경을 제공한다. 새로운 64GB 구성은 주요 제조사 파트너를 통해 제공되며, 도입 부담을 낮춘 가격대로 제공된다. 기존 128GB 모델과 동일한 GB10 그레이스 블랙웰 슈퍼칩(Grace Blackwell Superchip), DGX OS, 전체 엔비디아 AI 소프트웨어 스택을 그대로 제공하며, 최대 1,000억 파라미터 모델과 이를 기반으로 구축된 에이전트 애플리케이션을 디바이스에서 완전히 실행할 수 있다. 64GB 시스템 두 대를 클러스터로 연결하면 메모리와 성능을 함께 확장할 수 있다. 엔비디아가 자체적으로 진행한 큐원(Qwen) 3.8 27B 테스트에서 두 시스템을 클러스터로 구성했을 때 단일 시스템 대비 최대 1.7배의 성능을 기록했다. 또한 워크로드 요구에 따른 추가 확장도 가능하다. DGX 스파크는 에이전트 개발에 필요한 환경을 갖췄다. 엔비디아 에이전트 툴킷(Agent Toolkit), 쿠다-X(CUDA-X) AI 라이브러리, 네모트론(Nemotron) 오픈 모델과 올라마(Ollama), vLLM, 쿠다 지원 파이토치(PyTorch) 등 주요 런타임을 기본 지원한다. 개발자는 전원을 켠 후 몇 분 만에 모델을 실행할 수 있다. 블렌더(Blender)는 이 플랫폼을 지원하는 최초의 주요 크리에이터 애플리케이션 중 하나로, 사전 구성된 설치 프로그램이 곧 제공될 예정이다. 엔비디아 싱크 클러스터 어시스턴트로 손쉽게 확장 개발자는 현재 프로젝트에 필요한 메모리로 시작해, 파이프라인이 확장됨에 따라 커진 워크로드에 맞춰 멀티 노드 클러스터로 원활하게 확장할 수 있다. 모든 DGX 스파크에는 엔비디아 커넥트X-7 NIC가 기본 탑재된다. 이와 함께 두 대의 시스템을 QSFP 케이블로 직접 연결해 메모리를 128GB로 확장하고, 최대 2,000억 파라미터 모델까지 지원 범위를 확장할 수 있다. 동시에 메모리 대역폭을 두 배로 늘리고 최대 1.7배의 성능을 활용할 수 있다. 엔비디아 싱크(Sync) 앱은 간편한 멀티 노드 클러스터 구성을 지원한다. 클러스터 어시스턴트 기능은 연결된 시스템을 감지하고, 디바이스 구성을 검증하며, 커넥트X-7 네트워크를 구성해 개발자가 인프라보다 작업 자체에 집중할 수 있도록 한다. 모든 노드는 동일한 엔비디아 소프트웨어 스택을 활용하므로, 한 대에서 두 대로 확장할 때 소프트웨어를 다시 구성할 필요가 없다. 한편 이달 말부터 엔비디아 싱크 모델 런처(Sync Model Launcher)를 통해 몇 번의 클릭만으로 로컬 AI를 간편하게 실행할 수 있다. 개발자는 단일 DGX 스파크 시스템 또는 클러스터에서 큐원 3.8 27B를 다운로드하고 실행할 수 있으며, 엔비디아 싱크가 연결된 디바이스에서 모델이 실행되도록 구성해 노트북에서도 해당 모델에 접근할 수 있다. 아울러 런처는 오픈코드(OpenCode)가 해당 모델을 사용할 수 있도록 설정해, 개발자가 브라우저에서 바로 코딩을 시작할 수 있도록 지원한다. DGX 스파크 개발자 활용 사례 새로운 DGX 스파크 64GB는 최대 1,000억 파라미터 모델을 디바이스에서 완전히 실행할 수 있어 다양한 작업에 활용할 수 있다. 개발자와 AI 애호가는 메모리 용량에 맞는 모델을 단일 시스템에서 실행할 수 있으며, 더 많은 메모리와 컴퓨팅이 필요한 워크로드의 경우 엔비디아 싱크 클러스터 어시스턴트를 통해 여러 대의 DGX 스파크를 연결할 수 있다. 다음은 세 가지 주요 워크플로우 예시다: - AI 에이전트 24시간 실행: DGX 스파크에서 코딩 또는 연구용 에이전트를 실행해 코드를 검토하고, 문서를 분석하거나, 여러 단계의 작업을 수행할 수 있다. 클러스터를 구성하면 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 동시에 작동하는 여러 에이전트를 위한 추가 용량을 확보할 수 있다. - 일상적으로 활용하는 PC에서 AI 애플리케이션 구동: 노트북이나 데스크톱에서 에이전트 또는 크리에이티브 애플리케이션을 사용하는 동시에 DGX 스파크에서 언어 또는 이미지 생성 모델을 실행할 수 있다. DGX 스파크가 모델 추론을 처리하는 동안 PC에서는 다른 작업을 수행할 수 있다. - 워크로드 증가에 따른 확장: 하나의 작업이 단일 시스템의 처리 범위를 넘어 더 큰 모델, 더 긴 컨텍스트 윈도우 또는 여러 에이전트 요청을 동시에 처리해야 하는 경우, 엔비디아 싱크 클러스터 어시스턴트를 활용할 수 있다. 200 GbE 패브릭으로 연결된 두 대의 DGX 스파크 64GB 시스템은 메모리를 128GB로 통합하며, 소프트웨어 환경을 재구성할 필요 없이 한 대에서 실행하던 워크플로우를 두 대로 확장할 수 있다. DGX 스파크 시작하기 DGX 스파크 64GB는 10월 23일(현지 시간)을 시작으로 에이서, 에이수스, 델, 기가바이트, HP, MSI를 통해 4,999달러부터 구매할 수 있다. @nvidia @msi @gigabyte @acer
- NVIDIADGXXSpark
- 개인AI슈퍼컴퓨터
- 로컬AI
- AI개발
5
6
애즈락 ROCK White 360 Digital 수랭쿨러 [써보니]
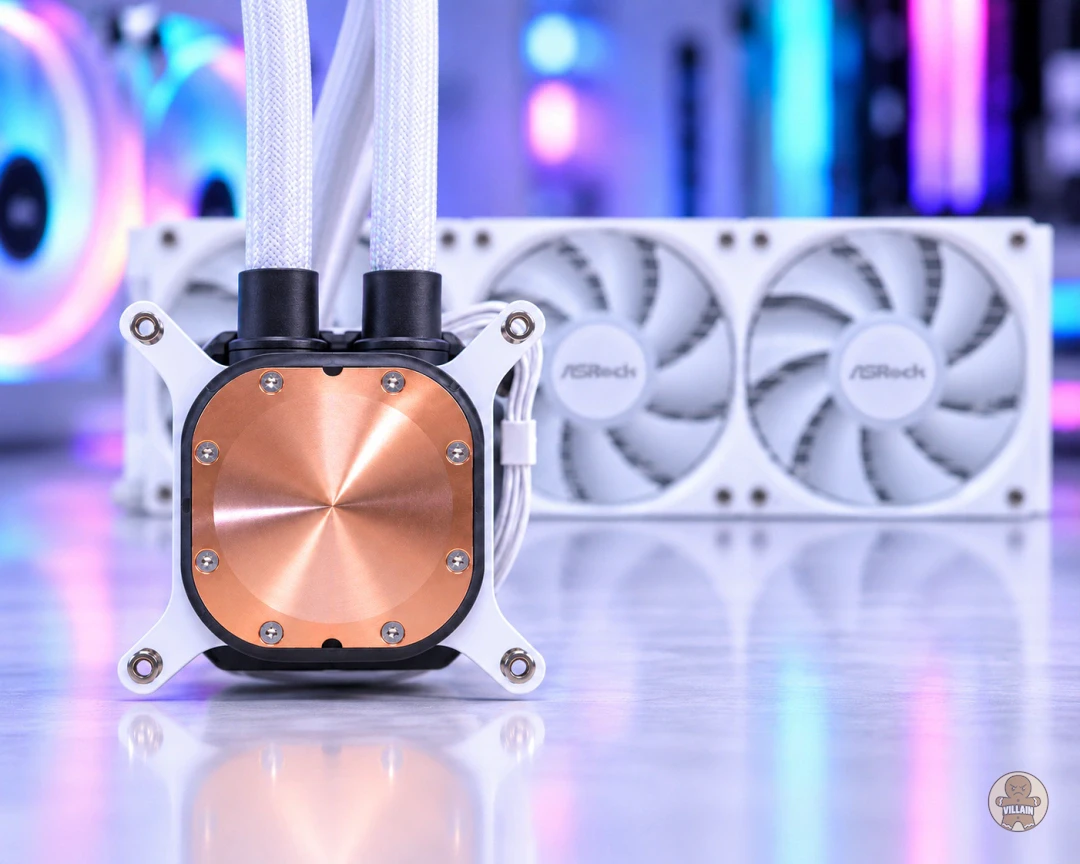
메인보드와 그래픽카드에서 익숙했던 애즈락이 PC 냉각 시장까지 영역을 넓혔다. CES에서 공랭과 일체형 수랭쿨러를 대거 선보인 데 이어 Phantom Gaming과 Steel Legend, Challenger, ROCK으로 제품군을 나눴다. 브랜드 이름만 빌려 몇 가지 제품을 추가한 수준보다는 가격과 기능에 따라 선택지를 세분화하려는 움직임에 가깝다. ROCK는 그 가운데 가격 부담을 낮춘 보급형 라인업을 맡았다. 그렇다고 구성까지 단순하게 줄이지는 않았다. 360mm 라디에이터와 120mm 팬 3개를 기본으로 사용하고 워터블록에는 CPU 상태를 확인하는 디지털 디스플레이를 넣었다. ARGB 조명과 애즈락 Polychrome RGB Sync도 지원한다. 제조사가 제시한 대응 TDP는 최대 350W이며 보증기간도 6년이다. 미국 기준 판매가격은 69.99달러다. 360mm 일체형 수랭쿨러가 흔해진 시장이라지만 디지털 표시장치와 통합형 팬까지 갖춘 제품이라는 점을 감안하면 가격도 가성비라는 문구에 걸맞다. 화려한 LCD 대신 필요한 정보만 보여준다 ROCK White 360 Digital의 성격은 워터블록에서 가장 쉽게 드러난다. 최근 고급형 수랭쿨러가 대형 LCD를 달고 이미지나 GIF, 시스템 정보를 띄우는 방향으로 발전했다면 ROCK는 필요한 부분만 남겼다. 워터블록에 적용한 화면은 1.05인치 디지털 디스플레이다. CPU 온도와 CPU 동작 속도, 펌프 회전속도를 표시하며 메인보드 USB 9핀 헤더와 연결해 사용한다. 화면 바로 아래에는 ARGB 조명부를 배치했다. 조명 효과는 애즈락 Polychrome RGB Sync에서 다른 부품과 함께 제어할 수 있다. 작은 화면 만큼이나 디스플레이 역할은 한정되어 있다. PC를 사용하다 CPU 상태가 궁금할 때 워터블록만 확인하면 기본적인 상태를 파악할 수 있게 했다. LCD가 커질수록 제품 가격도 함께 높아지는 만큼 보급형 제품에서는 오히려 이런 접근이 현실적이다. 전체 색상은 라디에이터부터 팬과 튜브, 워터블록까지 흰색으로 통일했다. 화이트 시스템을 구성할 때 검은색 부품이 중간에 섞여 시선을 끄는 문제도 적다. 블랙 색상도 별도로 마련돼 시스템 색상에 맞춰 선택할 수 있다. 360mm 라디에이터 크기는 397×120×27mm다. 알루미늄 핀을 촘촘하게 배치한 일반적인 3열 구조지만 팬을 장착하는 방식에는 차이를 뒀다. 특이한 부분은 120mm 팬 3개가 하나의 프레임으로 연결돼 있다. 수랭쿨러를 처음 설치하면 의외로 시간을 잡아먹는 부분이 팬이다. 팬 3개를 각각 라디에이터에 고정하고 PWM과 ARGB 케이블을 정리하다 보면 케이스 내부에 선이 빠르게 늘어난다. ROCK White 360 Digital은 팬을 하나의 프레임으로 묶어 출고 단계부터 라디에이터에 장착했다. 연결도 심플하다. 통합 프레임에서 하나의 4핀 PWM 케이블만 나온다. 조립 시간을 줄이는 동시에 라디에이터 주변에 노출되는 배선을 줄일 수 있다. 팬 동작 범위는 0~1850RPM이며 최대 풍량은 52.4CFM, 최대 풍압은 1.7mmH₂O다. 제조사가 밝힌 최대 소음은 30.7dBA다. 낮은 부하에서는 팬을 멈추는 0RPM 기능도 지원한다. 1850RPM이라는 회전수만 보면 고회전 360mm 수랭쿨러보다 얌전하다. 2500RPM을 넘어 3000RPM까지 회전하는 팬처럼 무조건 풍량과 풍압에 힘주는 제품과는 결이 다르다. 보급형임에도 애즈락은 3상, 6슬롯, 4극 모터를 사용한 펌프를 적용했다. 냉각수가 워터블록 내부의 고밀도 마이크로핀을 지나면서 한쪽에 흐름이 집중되지 않도록 양방향 유입 설계도 반영했다. 냉각수 이동 거리를 줄이고 고밀도 마이크로핀 전체에 흐름을 고르게 전달하기 위한 설계다. CPU와 맞닿는 바닥에는 넓은 구리 베이스를 사용했다. 인텔 LGA1700·LGA1851과 AMD AM4·AM5를 지원해 현재 조립 PC에서 사용하는 주요 플랫폼을 대부분 아우른다. 튜브 길이는 400mm다. IIR과 EPDM 소재를 사용하고 바깥쪽에는 직조 슬리브를 씌웠다. 라디에이터를 케이스 상단이나 전면에 설치할 때 길이가 부족할 가능성을 줄였으며 튜브를 나란히 정리할 수 있는 클립도 기본으로 제공한다. 설치 부품 역시 인텔과 AMD용으로 나눠 제공한다. 애즈락 Therm-X1 서멀컴파운드도 기본 구성에 포함된다. 처음부터 팬이 장착돼 있고 연결해야 할 팬 케이블 수도 적은 만큼 설치 난도는 360mm 수랭쿨러 가운데 비교적 낮은 편이다. 라이젠 9 7950X3D에서도 최대 73℃ 냉각 성능은 AMD 라이젠 9 7950X3D를 기준으로 확인했다. 아이들 상태에서 기록한 CPU 온도는 30℃다. 같은 환경에서 NZXT Kraken Elite V2 360이 29℃를 기록했고 애즈락 Phantom Gaming 360 LCD와 Steel Legend 360 LCD, Challenger 360 Digital을 비롯한 다수의 360mm 제품이 30℃를 나타냈다. 부하가 거의 없는 상태에서는 여타 제품과 견주어도 의미 있는 차이를 찾기 어려운 결과다. 차이는 CPU에 부하를 걸었을 때 나타났다. 팬을 최대 속도로 동작시킨 멀티스레드 작업에서 ROCK White 360 Digital은 73℃를 기록했다. Phantom Gaming 360 LCD는 69℃, Steel Legend 360 LCD는 71℃였고 Challenger 360 Digital은 ROCK와 같은 73℃였다. 가격대가 높은 상위 제품보다 2~4℃ 높았지만 7950X3D를 사용한 결과라는 점을 감안하면 부족한 냉각 성능으로 보기는 어렵다. 커세어 H150i ELITE와 MSI MEG S360 역시 73℃였으며 DeepCool LS720은 75℃였다. 공랭 제품인 Noctua NH-D15는 78℃, DeepCool AK620은 79℃를 기록했다. 게이밍 환경에서는 54℃를 기록했다. Phantom Gaming 360 LCD는 49℃, Steel Legend 360 LCD는 52℃, Challenger 360 Digital은 53℃였다. 커세어 H150i ELITE는 55℃, DeepCool LS720과 Castle 360EX는 각각 56℃였다. 성능 순위만 놓고 보면 ROCK보다 낮은 온도를 기록한 제품이 여럿 있다. 하지만 제품 가격까지 함께 놓으면 해석이 달라진다. 70달러 안팎의 제품이 고급형 360mm 수랭쿨러와 몇 도 정도 차이를 두고 같은 비교군 안에 들어왔다는 점이 오히려 ROCK의 위치를 설명한다. 물론 온도만큼 중요한 부분이 소음이다. 수랭쿨러는 펌프가 계속 동작하고 라디에이터에 여러 개의 팬을 사용하는 만큼 냉각 성능을 높이기 위해 팬 속도를 지나치게 올리면 소음에서 손해를 보기 쉽다. 75% 정규화 조건에서 ROCK White 360 Digital은 아이들 34dBA, 부하 51dBA를 기록했다. 비슷한 조건에서 Phantom Gaming 360 LCD는 32dBA와 49dBA, NZXT Kraken Elite V2 360은 33dBA와 50dBA였다. MSI MPG CoreLiquid P13 360은 부하에서 48dBA까지 낮아졌다. 반대로 Challenger 360 Digital은 54dBA, ASUS Ryujin II 360은 55dBA까지 올라갔다. 결국은 가격! 70달러라는 가격이 깡패다. 비싼 360mm 수랭쿨러와 비교하면 LCD 크기도 작고 CPU 부하 테스트에서도 몇 도 정도 차이가 났다. 최고 성능만 놓고 순위를 매긴다면 상위 제품을 선택할 이유는 충분하다. 하지만 CPU를 식히는 데 200달러 안팎의 비용을 들이고 싶지 않은 사용자에게 같은 논리를 적용하기는 어렵다. 라이젠 9 7950X3D 멀티스레드 부하를 73℃로 억제했고 게임에서는 54℃를 기록했다. 120mm 팬 3개를 하나로 묶어 설치 과정과 배선을 줄였고 400mm 튜브도 라디에이터 위치를 정할 때 여유를 준다. 1.05인치 디지털 화면 역시 크지 않지만 CPU 온도와 클럭, 펌프 상태를 확인하는 데 필요한 역할은 한다. 여기에 6년 보증까지 더했다. 360mm 수랭쿨러를 선택하는 이유가 화면을 감상하기 위해서가 아니라 CPU를 안정적으로 식히기 위해서라면 가격을 포함 모든 조건을 완벽하게 충족한다. 말이나왔으니 말인데 CPU를 식히기 위해 수랭쿨러를 사는 사용자가 굳이 화면 크기로 경쟁할 필요는 없다. ROCK White 360 Digital은 불필요한 부분까지 신경쓰고 싶지 않은 사용자에게 꽤나 현실적인 선택지가 된다. @ASROCK
- 애즈락
- 수랭쿨러
- 락
- ROCK
- 화이트
- ASROCK
7
10
엔비디아 젠슨 황 CEO, 2026 밴 플리트상 수상…“한국과 미국, 함께 미래 만들어가고 있어”
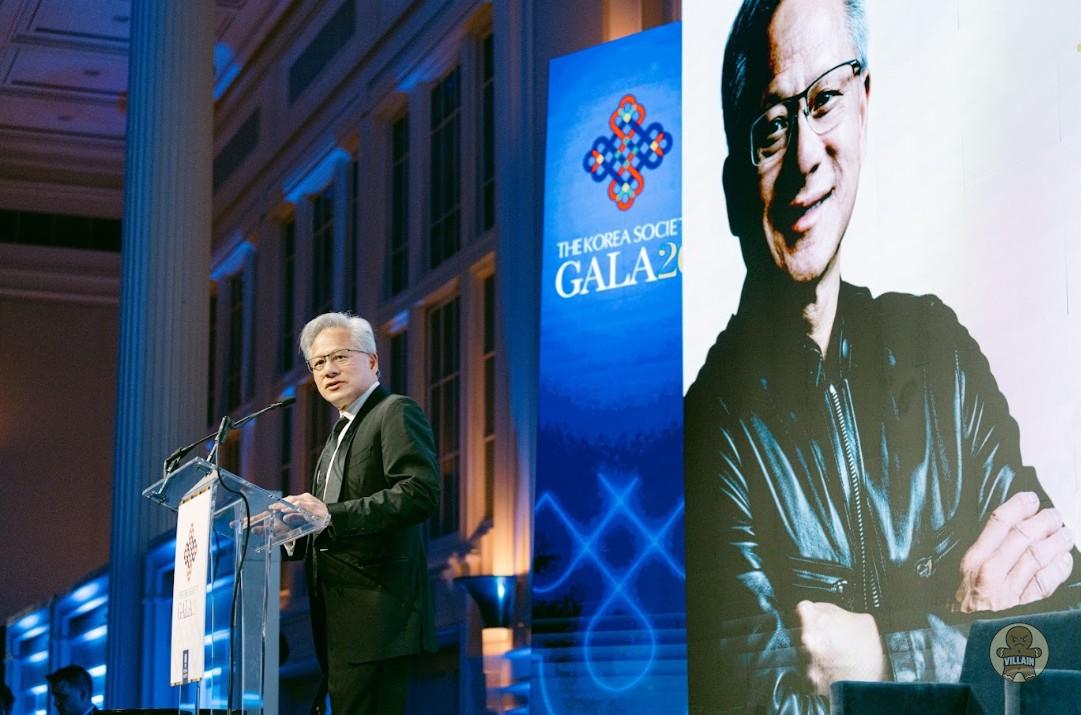
엔비디아 창립자 겸 CEO 젠슨 황(Jensen Huang)이 지난 9월 28일(현지 시간) 미국 뉴욕에서 열린 코리아 소사이어티(The Korea Society) 연례 갈라에서 2026 밴 플리트상(James A. Van Fleet Award)을 수상했다. 밴 플리트상은 한미 관계 발전에 크게 기여한 개인이나 기관에 수여되는 상이다. 이번 수상은 엔비디아가 AI, 반도체, 컴퓨팅 전반에서 한국의 기술·산업 생태계와 긴밀한 협력을 이어가고 있는 가운데 이뤄졌다. 젠슨 황 CEO는 수상소감을 통해 한국과 오랜 기간 이어온 인연을 돌아보고, AI 시대에서 한국이 수행할 역할에 대한 기대를 밝혔다. 수십 년간 이어진 한국과의 인연, 한국의 변화 “놀라운 기적” 젠슨 황 CEO는 엔비디아 초창기부터 한국과 쌓아온 오랜 인연 덕분에 이번 수상이 자신에게 더욱 특별한 의미를 지닌다고 말했다. 그는 회사를 세우고 새로운 컴퓨팅 산업을 개척해 나가던 시절 처음 한국과 인연을 맺었다고 회상했다. 이후 수십 년 동안 한국과 함께 성장하며, 기술을 받아들이던 국가에서 글로벌 기술 산업의 최전선에 선 국가로 변화하는 과정을 직접 지켜봤다고 말했다. 젠슨 황 CEO는 지난 수십 년간 한국이 이뤄낸 변화를 “놀라운 기적”이라고 표현하며, 한국인의 회복탄력성과 더 큰 도약을 향한 열망을 강조했다. 또한 한미 관계가 그 어느 때보다 중요한 의미를 지니는 시점에 두 위대한 국가가 만나는 지점에 설 수 있어 자랑스럽다고 말했다. AI 시대, 한국의 차별화된 강점 젠슨 황 CEO는 시상식 후 진행된 대담에서 한국이 AI를 적극적으로 활용하는 동시에 이를 수출할 수 있는 역량을 갖추고 있다고 강조했다. 그는 기술에 대한 한국의 열정을 핵심 강점으로 제시하며, 한국은 새로운 기술을 개발하는 데 그치지 않고 이를 사회와 산업 전반에 빠르게 확산할 수 있는 유리한 위치에 있다고 설명했다. 함께 구축하는 ‘인텔리전스 팩토리’ 젠슨 황 CEO는 AI를 전기와 인터넷에 이은 새로운 형태의 인프라로 설명하며, 앞으로 국가와 사회, 기업에 점점 더 큰 동력을 제공할 것이라고 말했다. 또한 한국의 제조 역량을 강조하며, 한국이 사회에 동력을 제공할 ‘인텔리전스 팩토리’를 구축하고 있으며 엔비디아와 함께 이를 만들어가고 있다고 말했다. 이와 함께 양측이 함께 만들어갈 미래에 대한 기대를 밝혔다. 젠슨 황 CEO는 “두 위대한 국가가 만나는 지점에 서서, 양국이 함께 미래를 만들어가는 여정에 동참할 수 있어 큰 영광”이라고 말했다. 이번 행사에서 젠슨 황 CEO는 한국과의 오랜 인연을 돌아보고, AI 시대 한국의 기술 수용력과 제조 역량에 대한 기대를 강조했다. @nvidia
16
15
MSI
@msi
PC/주변기기
|
26-10-04
MSI ‘크로스헤어 A16 HX MLG 에디션’ 한정판 노트북 출시
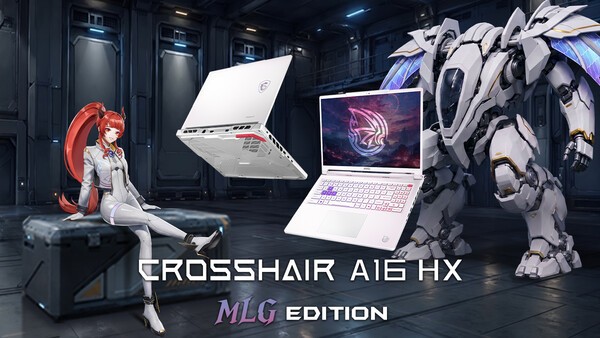
엠에스아이코리아는 MSI 독자 IP ‘MLG’의 세계관과 고성능 게이밍 하드웨어를 결합한 한정판 노트북 ‘MSI 크로스헤어 A16 HX MLG 에디션’을 국내 출시하고 예약 판매를 진행한다고 밝혔다. 신제품은 MSI 오리지널 캐릭터 ‘마룡공주 니아(LOONG:NIA)’의 이야기를 제품 디자인과 패키지에 담은 MLG 한정판 모델이다. MSI 독자 IP ‘MLG’ 세계관 담은 특별한 디자인 ‘MLG’는 MSI가 선보이는 오리지널 캐릭터 세계관으로, 주인공 마룡공주 니아의 도전과 모험을 중심으로 이야기가 펼쳐진다. 니아는 고대 용족의 혈통을 이어받았지만 날개 없이 태어난 소녀다. 자신의 한계를 운명으로 받아들이지 않고, 기계공학에 대한 재능을 바탕으로 직접 날개를 만들어 하늘을 날아오른다. 이를 통해 기술과 창의력으로 한계를 극복하고 새로운 가능성에 도전한다는 메시지를 전한다. 크로스헤어 A16 HX MLG 에디션은 이러한 세계관을 제품 디자인에 반영했다. 진주처럼 은은하게 빛나는 스텔라 화이트(Stellar White) 컬러를 기반으로 MLG 아이콘과 드래곤 실드, 화이트 키보드, 4존 RGB 조명, 레드 포인트 패드 등을 적용했다. 화이트와 레드 컬러의 대비를 통해 MLG 특유의 판타지 감성과 게이밍 이미지를 살렸다. 라이젠 9 8940HX · RTX 5070 GPU 탑재 이 제품은 AMD 라이젠 9 8940HX 프로세서와 NVIDIA GeForce RTX 5070 GPU를 탑재했다. 라이젠 9 8940HX는 최대 16코어 32스레드를 지원해 고사양 게임은 물론 영상 편집과 콘텐츠 제작 등 멀티코어 성능이 필요한 작업에도 대응한다. MSI 오버부스트(OverBoost) 기술을 통해 CPU와 GPU 합산 최대 190W의 전력 성능을 지원하며, 듀얼 팬과 5개의 히트파이프, 4개의 배기구로 구성된 쿨러부스트(Cooler Boost) 쿨링 시스템을 적용했다. 디스플레이는 16형 QHD+(2560×1600) 해상도와 240Hz 고주사율을 지원한다. DCI-P3 100% 색 영역을 지원해 빠른 화면 전환이 필요한 게임부터 영상 및 콘텐츠 제작까지 폭넓게 활용할 수 있다. MLG 전용 패키지와 니아 피규어 제공 크로스헤어 A16 HX MLG 에디션 구매자에게는 MLG 에디션 마우스, 헤드셋, 확장형 게이밍 마우스패드로 구성된 전용 패키지와 마룡공주 니아 피규어가 제공된다. 제품부터 주변기기, 피규어까지 MLG 콘셉트로 구성해 한정판의 소장 가치를 높였다. 구매자를 위한 추가 이벤트도 진행된다. 제품 구매 후 MSI 홈페이지에서 이벤트에 참여하면 행사별 조건에 따라 사이버링크 포토디렉터 365 3개월 이용권, 어도비 크리에이티브 클라우드 1개월 이용권, 스팀 코드 3만원권을 각각 받을 수 있다. 이벤트 기간과 참여 방법, 증정 조건 등 자세한 내용은 제품 구매 페이지 및 MSI 코리아 공식 홈페이지에서 확인할 수 있다. 크로스헤어 A16 HX MLG 에디션 제품 보러가기 : https://msi.gm/S25101EC MSI 코리아 마케팅 담당자는 “MSI는 혁신적인 기술을 통해 사람들이 한계를 넘어 새로운 가능성에 도전하고, 꿈을 현실로 만들어 갈 수 있다고 믿는다”며 “이러한 정신을 MLG와 마룡공주 니아의 이야기에 담았다”고 말했다. 이어 “크로스헤어 A16 HX MLG 에디션은 MSI의 고성능 하드웨어 기술에 MLG 특유의 판타지적인 디자인과 스토리를 결합한 제품”이라며 “전용 액세서리와 니아 피규어까지 함께 구성해 MLG 에디션만의 매력을 느낄 수 있을 것”이라고 덧붙였다. @msi
- MSI
- MLG에디션
- 크로스헤어A16HX
- 한정판노트북
- 마룡공주니아
13
14
 AMD
@amd
PC/주변기기
|
26-10-04
AMD, 임베디드 설계 및 개발 전 과정에 에이전틱 AI 역량 제공
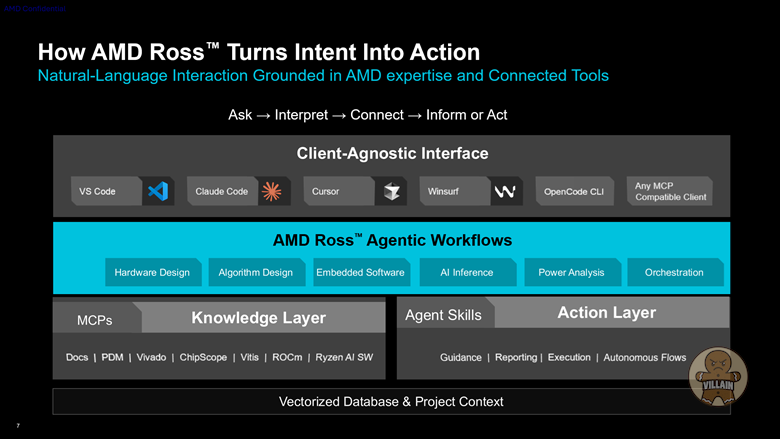
AMD 로스(AMD Ross)는 에이전틱 AI 어시스턴트는 소프트웨어부터 실리콘 및 보드 설계까지 아우르며, 기존 개발 수명주기 대비 임베디드 시스템의 설계, 최적화, 디버깅 및 구축을 대폭 가속화한다. 제품 소개 : AMD는 전체 임베디드 개발 흐름을 가속화하도록 설계된 에이전틱 AI 어시스턴트 AMD 로스를 공개했습니다. AMD 로스는 설계 아키텍처 수립부터 최적화, 디버깅, PCB 설계, 회로도 검토, 소프트웨어, AI 및 실제 시스템 구축에 이르는 전 과정을 가속화하도록 설계됐다. AMD 로스는 자연어 기반 툴 상호작용과 전문가가 개발한 에이전트 스킬의 배포를 지원하며, 재사용 가능한 워크플로우와 AMD의 검증된 정보를 기반으로 하는 AMD 지식 베이스(AMD Knowledge Base)를 활용해 전체 설계 과정을 안내한다. 또한 툴과 연결해 전문 지식의 활용 범위를 확대하고, 검증된 반복형 워크플로우를 자동화하며 결과를 분석함으로써¹ 엔지니어가 설계 의도에서 구현으로 빠르게 전환할 수 있도록 지원하고, 일반적인 임베디드 개발 주기를 대폭 단축한다. 도입 효과 : AMD 임베디드 제품은 FPGA, 적응형 SoC, 임베디드 x86 프로세서 및 특화된 엣지 AI 플랫폼을 아우르며, 이를 뒷받침하는 다양한 개발 툴과 워크플로우 생태계를 제공한다. 설계가 점차 복잡해짐에 따라 엔지니어는 전체 시스템 개발 수명주기에서 이러한 리소스와 검증된 엔지니어링 방식을 보다 효율적으로 활용할 수 있습니다. 전문가의 방법론을 재사용 가능한 에이전트 스킬에 담음으로써 조직은 전문 지식에 대한 접근성을 높이고, 보다 일관된 실행을 지원하며, 엔지니어가 더 높은 가치의 설계 과제에 집중할 수 있도록 한다. AMD 로스가 개발자를 지원하는 방식 : 살릴 라제(Salil Raje) AMD 임베디드 수석 부사장 겸 총괄은 “임베디드 개발은 팀이 하드웨어 설계 및 디버깅, 소프트웨어 개발 및 구축, AI 추론, 시스템 차원의 설계 등 다양한 영역을 아우르게 되면서 점차 복잡해지고 있다. AMD 로스는 고객이 일상적으로 사용하는 기술과 방법론을 기반으로 AMD 임베디드 툴, 신뢰할 수 있는 전문 지식, 전문가가 개발한 워크플로우를 하나의 에이전틱 AI 환경으로 통합합니다. AMD 로스는 임베디드 개발자에게 에이전틱 AI의 역량을 제공하고 전체 수명주기를 가속화해 제품 혁신이 설계 의도에서 구축 단계까지 더 빠르게 이어지도록 지원한다”라고 말했다. AMD 로스의 지원 범위 : AMD 로스는 하드웨어 설계 및 디버깅부터 소프트웨어 및 알고리즘 개발, 엣지 AI 구현과 구축에 이르기까지 임베디드 개발 전 과정을 지원한다. 개발자는 자연어를 사용해 AI 에이전트에 문서 검색, 툴 상태 확인, 명령 실행, 디버깅 안내 및 검증된 워크플로우 실행 등을 요청할 수 있다. AMD 로스는 AMD 임베디드 툴 포트폴리오 전반에서 다음 작업을 지원한다. - 하드웨어와 소프트웨어 파티셔닝 수행 - 고수준 합성 툴 기반 하드웨어 설계 구현 - 실리콘 설계 최적화 및 디버깅 - 임베디드 소프트웨어 애플리케이션 및 알고리즘 개발 - AMD 임베디드 AI 소프트웨어를 활용한 머신러닝 알고리즘 최적화 - 전력을 정확하게 추정하고 저전력 설계에 맞게 최적화 - 시스템 회로도 검토 및 최적의 보드 레이아웃 구현 AMD 로스는 특정 클라이언트에 종속되지 않으므로, 팀은 AMD 임베디드 개발 툴과의 연결을 유지하면서 선호하는 대규모 언어 모델(LLM), 통합 개발 환경(IDE) 및 명령줄 환경을 유연하게 사용할 수 있다. AMD 로스의 차별점 : 범용 AI 어시스턴트와 달리 AMD 로스는 AMD 임베디드 개발 환경, AMD가 축적해 온 엔지니어링 지식 및 전문가가 개발한 방법론을 기반으로 한다. AMD 로스는 단순히 개발 툴 위에 추가되는 AI 코딩 어시스턴트가 아니다. AMD 개발 환경에 대한 직접적인 접근과 AMD 문서, AMD가 개발한 워크플로우, 재사용 가능한 엔지니어링 전문 지식을 결합해 임베디드 개발에 특화된 환경을 제공한다. AMD 로스는 범용 코파일럿으로는 제공하기 어려운 상황별 가이드와 워크플로우 자동화를 제공하는 동시에, 사용자가 선호하는 LLM, IDE 및 명령줄 환경을 개방적으로 지원해 유연성을 유지합니다. 이를 위해 AMD 로스는 다음과 같은 네 가지 특화 구성 요소를 결합한다. 모델 컨텍스트 프로토콜(Model Context Protocol, MCP) 서버: 개방형 표준 기반 MCP 서버는 AI 에이전트를 AMD 임베디드 툴과 연결한다. 이를 통해 AMD 로스는 정보를 조회하고 명령을 실행하며 설계 환경 내에서 작업할 수 있다. AMD 지식 베이스 : AMD가 검증한 벡터화 데이터베이스에는 사용자 가이드, 제품 가이드, 백서, 애플리케이션 노트 및 질의응답 자료가 포함된다. 클라우드 또는 로컬에서 이용 가능한 오프라인 환경을 통해 AMD가 검증한 답변과 관련 문서에 접근할 수 있다. 에이전트 스킬(Agent skills) : 전문가가 작성한 개방형 마크다운(Markdown) 파일에 일반적인 설계 작업에 활용할 수 있는 반복 및 공유 가능한 모범 사례를 담았습니다. 이러한 스킬은 타이밍 최적화나 AMD 바이티스 HLS(AMD Vitis HLS)에서 C++ 설계를 재구성해 성능을 높이는 작업 등 체계적인 워크플로우를 LLM이 수행할 수 있도록 안내한다. 설계 예제(Design examples): 즉시 실행 가능한 설계를 통해 에이전트 스킬을 실제 임베디드 애플리케이션에 적용하는 방법을 보여준다. AMD 로스의 주요 기능 : AMD 로스는 설계 의도에서 구축에 이르는 개발팀의 여정을 가속화하도록 설계됐으며, 다음과 같은 이점을 제공한다. - AI 기반 워크플로우 자동화를 통한 프로토타입 개발 시간 단축 - AMD가 검증한 가이드 및 재사용 가능한 방법론을 통한 디버깅 및 최적화 주기 단축 - 반복적인 툴 상호작용과 작업을 자동화해 개발자 생산성 향상 - 검증된 전문가 워크플로우에 대한 접근을 통해 신규 엔지니어의 온보딩 가속화 - 팀과 프로젝트 전반에서 모범 사례를 일관되게 실행 - 조직에 축적된 엔지니어링 지식의 재사용성과 확장성 향상 아이웨이브 글로벌(iWave Global) FPGA SOM 사업부 어소시에이트 디렉터 기타 고빈다라지(Geetha Govindaraj)는 “AMD 로스 에이전틱 AI 어시스턴트는 당사의 개발 워크플로우에 매우 유용한 요소로 자리 잡았다. 문제를 보다 효율적으로 파악하고 해결할 수 있도록 지원해 디버깅 및 초기 구동 단계에 필요한 시간과 노력을 줄여줍니다”라고 말했다. AMD 로스를 활용한 워크플로우의 주요 예시는 다음과 같다. 자연어로 표현된 의도를 개발 작업으로 전환: 문서 검색, 툴 명령 실행, 코드 생성, 반복적인 설계 개선 및 설계 목표 달성을 위한 개발자 안내 등을 수행한다. 툴 오류 파악 및 해결 : 이해하기 쉬운 설명과 상황별 가이드, 문제 해결을 위한 권장 사항을 통해 오류를 파악하고 해결할 수 있도록 지원한다. 타이밍 문제 분석 : AMD 타이밍 방법론을 활용해 타이밍 위반을 식별하고 근본 원인을 설명하며 구현 개선 방안을 제안한다. 바이티스 HLS 설계 최적화 : 파이프라이닝, 루프 최적화, 프라그마(pragma) 삽입 및 아키텍처 개선을 위한 권장 사항을 제공한다. 하드웨어 디버깅 가속화 : 신호 캡처 안내, 디버그 코어 구성, 인터페이스 분석 및 근본 원인 파악을 통해 하드웨어 디버깅을 가속화한다. AMD 로스 이용 가능 시점: AMD 로스는 에이전틱 AI와 AMD의 전문 지식, 검증된 워크플로우를 결합하는 새로운 임베디드 개발 방식을 제시한다. 이를 통해 팀은 하드웨어, 소프트웨어, AI 및 시스템 설계 전반에서 보다 효율적으로 작업할 수 있다. 또한 엔지니어링 노하우에 대한 접근성과 재사용성을 높여 조직이 개발을 가속화하고 전문 지식의 활용을 확대하며 혁신적인 제품을 더욱 빠르게 시장에 출시할 수 있도록 지원한다. AMD 로스는 현재 이용할 수 있다. 개발자는 AMD.com/Ross에서 AMD 로스를 활용한 에이전틱 AI 여정을 시작할 수 있다. AMD는 AMD 로스에 추가 임베디드 툴과 워크플로우 기능을 매월 순차적으로 제공할 계획이다. @amd
12
15
마지막 입니다.




 0 / 0




 6
 4