빌런 TOP 20
일간
l
주간
l
월간
1
[컴퓨터]
조텍코리아 '2026 개천절 대체휴일 & 한글날' 휴무 안내
2
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가
3
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
4
[인공지능]
엔비디아, 구글 팔콘 트랜스포트 지원… 커넥트X-10 기반 AI 네트워킹 상호운용성 강화
5
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행
6
[컴퓨터]
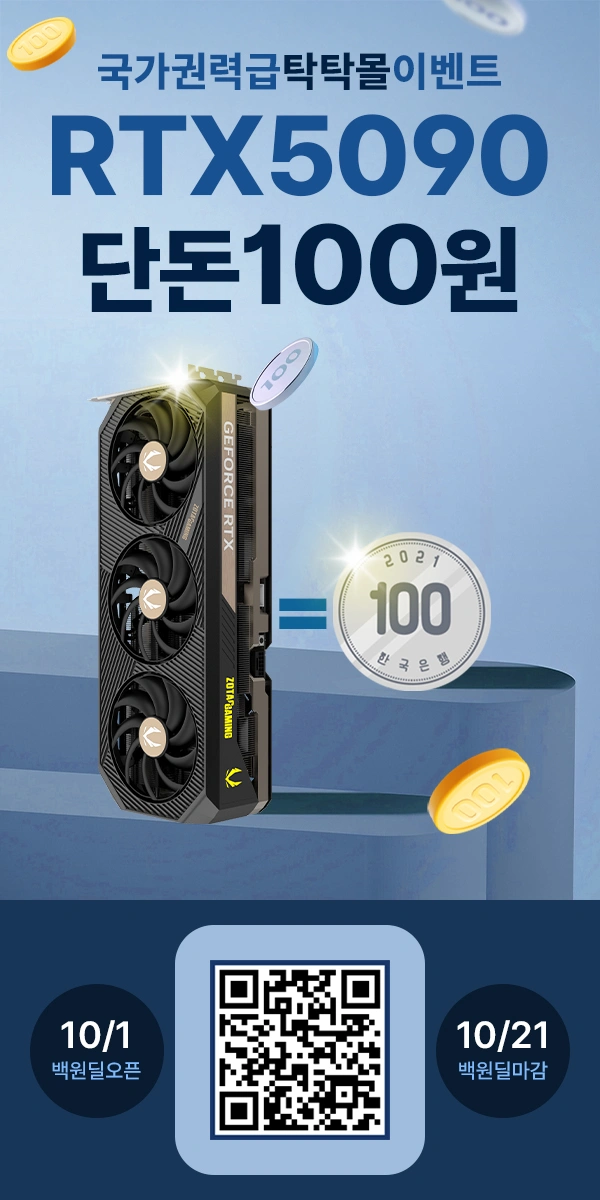
RTX 5090을 또 100원에 판다! 탁탁몰, 조텍 RTX 5090 ‘100원딜’ 이벤트 앵콜 진행
7
[인공지능]
에이수스, 엔비디아 RTX Spark 탑재 차세대 AI 크리에이터 노트북 ‘ProArt P16 및 P14’ 공개
8
[컴퓨터]
레이저, 5만 DPI 광학 센서와 8000H의 차세대 무선 게이밍 마우스 '바실리스크 V4 PRO' 출시
9
[컴퓨터]
이엠텍, PALIT 지포스 RTX 5080 INFINITY 3 출시!
10
[항공우주]
DJI, 25초만에 자동으로 배터리 교체하는 첫 드론 도크 출시
11
[상품/홍보]
세부 카지노 여행 준비, 누스타호텔 프리룸부터 공항픽업까지 로얄탐
12
[일상/생활]
대부분의 상체운동은 하면 안된다는 정형외과 의사 ㅎㄷㄷ
13
[유머]
히로시마 투하폭탄의 1.5배가 물속에서 터졌다
1
[컴퓨터]
조텍코리아 '2026 개천절 대체휴일 & 한글날' 휴무 안내
2
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가
3
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
4
[컴퓨터]
RTX 5090을 또 100원에 판다! 탁탁몰, 조텍 RTX 5090 ‘100원딜’ 이벤트 앵콜 진행
5
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행
6
[컴퓨터]
17만 원 상당 CPU 쿨러 단돈 1만 원! 조텍, 탁탁 래플 이벤트 9월 진행
7
[컴퓨터]
조텍코리아 '2026 추석 한가위' 휴무 안내
1
[컴퓨터]
조텍코리아 '2026 개천절 대체휴일 & 한글날' 휴무 안내
2
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가
3
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
4
[컴퓨터]
RTX 5090을 또 100원에 판다! 탁탁몰, 조텍 RTX 5090 ‘100원딜’ 이벤트 앵콜 진행
5
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행
6
[컴퓨터]
엔비디아, ‘컨트롤 레조넌트’에 패스 트레이싱·DLSS 4.5 지원
7
[인공지능]
엔비디아 DGX 스파크 64GB, 23일 최초 공개... 최대 1,000억 파라미터 모델 로컬 실행


브랜드로그

 0 / 0
0 / 0


엔비디아, ‘RTX 스파크’ 정식 출시… 윈도우 PC의 새로운 시작
 엔비디아
@nvidia
9시간전
엔비디아
@nvidia
9시간전




- 이벤트 l
- 체험단 모집 l
- 특가 이벤트 l
- 당첨/발표
- [체험단 모집] 맥스엘리트 850W 파워 체험단 모집
-
2026.01.21
 6
 4
- [특가 이벤트] 잘만, HPS800W 무선 헤드셋 및 HPS610 헤드셋 특가 및 포토리뷰 이벤트
-
2026.05.26
0
0
- [특가 이벤트] 크록스 스프링 페스타 3월 18일, 최대 6만원 추가 할인
-
2026.03.16
1
1
- [특가 이벤트] 3/3(화) 오후 8시, UP TO 50% + 라이브 단독 1만원 추가 할인
-
2026.03.02
0
0
- [특가 이벤트] 크록스 코리아 남성 BEST 클로그 5% 쿠폰 혜택
-
2026.02.26
0
1
- [당첨/발표] [발표] 댓글학원 우등생 TOP 5 발표
-
2026.09.29
15
13
- [당첨/발표] [발표] 댓글학원 우등생 TOP 5 발표
-
2026.07.22
10
6
- [당첨/발표] [발표] AI에이전트 미니PC지원 댓글이벤트 당첨자 발표
-
2026.04.06
6
3
- [당첨/발표] 맥스엘리트 850W 체험단 당첨자 발표
-
2026.02.02
3
2
- [당첨/발표] 1월 베스트 빌런 댓글러 이벤트 당첨자 발표
-
2026.02.02
5
3

- 종합
- 뉴스/정보
- 커뮤니티
- 질문/토론