전체 게시글
빌런 TOP 20
일간
l
주간
l
월간
1
[컴퓨터]
조텍코리아 '2026 개천절 대체휴일 & 한글날' 휴무 안내
2
[컴퓨터]
인사이 음식물처리기 쏜다! 탁탁몰, 한글날 기념 ‘우리말 대잔치’ 이벤트 진행
3
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
4
[컴퓨터]
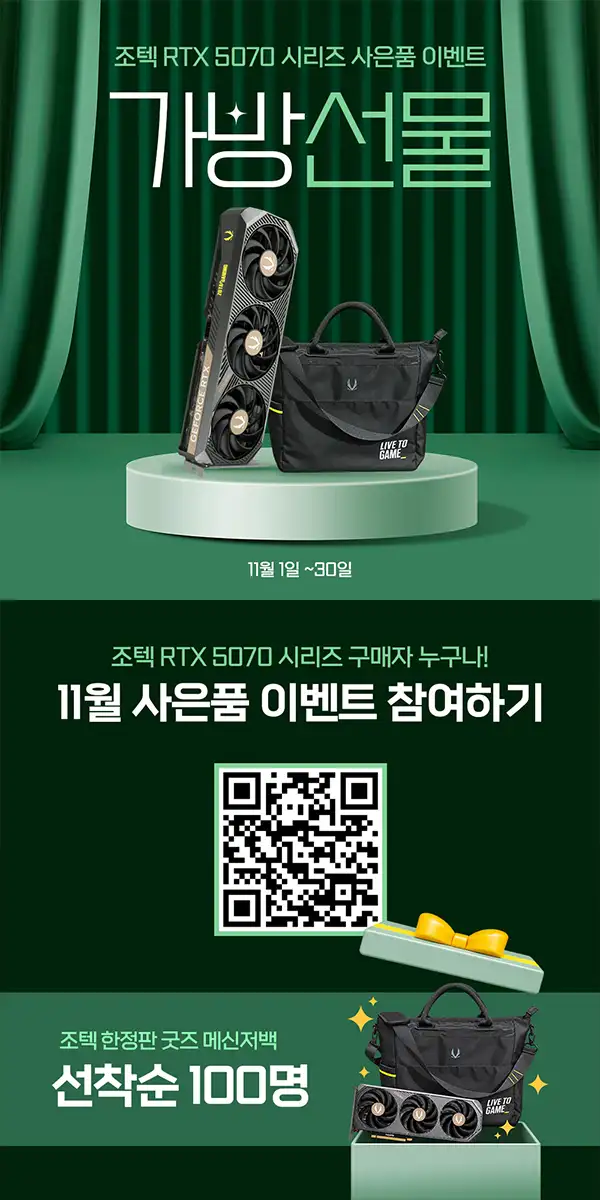
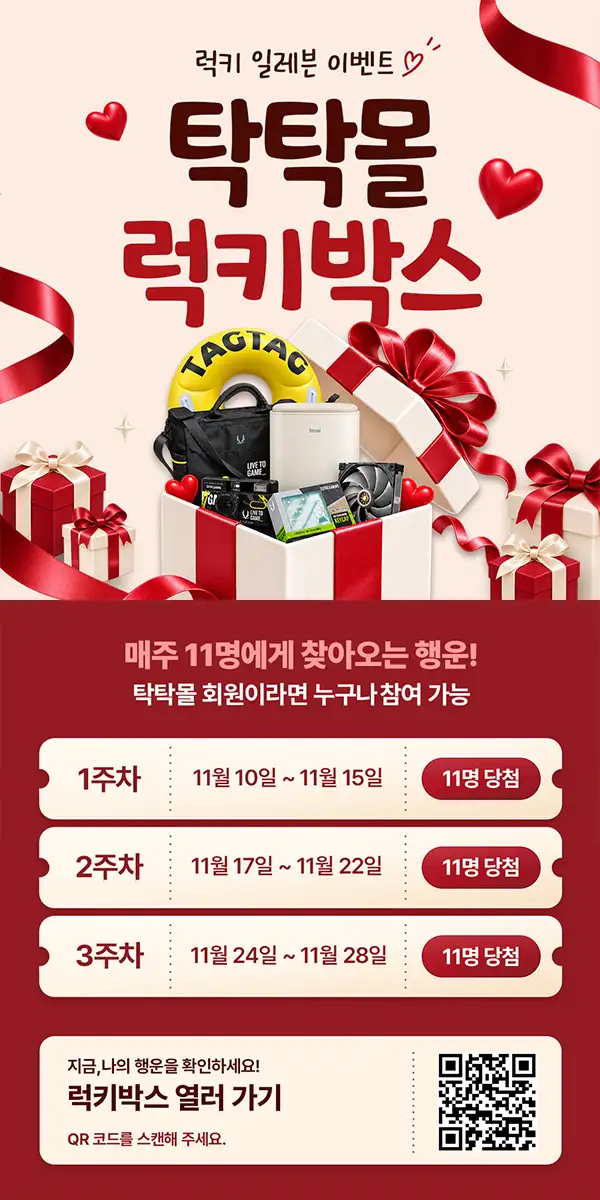
최대 100만원 혜택! 탁탁몰, 10만 회원 달성 이벤트 진행
5
[컴퓨터]
조텍코리아 '2026 가을 워크샵' 휴무 안내
6
[컴퓨터]
RTX 5080 및 쿨러 세트 200만 원대! 조텍, 화이트 그래픽카드 선착순 특가 진행
7
[컴퓨터]
RTX 5090을 또 100원에 판다! 탁탁몰, 조텍 RTX 5090 ‘100원딜’ 이벤트 앵콜 진행
8
[컴퓨터]
조텍 RTX 5090 약 47만 달러어치, 브라질 공항에서 행방불명
9
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행
10
[컴퓨터]
조텍, 인텔 와일드캣 레이크 프로세서 탑재한 팬리스 ZBOX 미니 PC 3종 공개
1
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
2
[컴퓨터]
조텍코리아 '2026 가을 워크샵' 휴무 안내
3
[컴퓨터]
RTX 5080 및 쿨러 세트 200만 원대! 조텍, 화이트 그래픽카드 선착순 특가 진행
4
[컴퓨터]
조텍, 인텔 와일드캣 레이크 프로세서 탑재한 팬리스 ZBOX 미니 PC 3종 공개
5
[컴퓨터]
RTX 5090을 또 100원에 판다! 탁탁몰, 조텍 RTX 5090 ‘100원딜’ 이벤트 앵콜 진행
6
[컴퓨터]
인사이 음식물처리기 쏜다! 탁탁몰, 한글날 기념 ‘우리말 대잔치’ 이벤트 진행
7
[컴퓨터]
최대 100만원 혜택! 탁탁몰, 10만 회원 달성 이벤트 진행
8
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행
1
[컴퓨터]
조텍코리아 '2026 가을 워크샵' 휴무 안내
2
[컴퓨터]
RTX 5080 및 쿨러 세트 200만 원대! 조텍, 화이트 그래픽카드 선착순 특가 진행
3
[컴퓨터]
조텍, 인텔 와일드캣 레이크 프로세서 탑재한 팬리스 ZBOX 미니 PC 3종 공개
4
[컴퓨터]
조텍코리아 '2026 추석 한가위' 휴무 안내
5
[컴퓨터]
RTX 5080 특가에 CPU 쿨러 사은품! 조텍, 지포스 그래픽카드 선착순 특가 진행
6
[컴퓨터]
최대 100만원 혜택! 탁탁몰, 10만 회원 달성 이벤트 진행
7
[컴퓨터]
조텍, RTX 50 그래픽카드 대상 ‘컨트롤 레조넌트’ 게임 번들 프로모션 연장 진행


브랜드로그

 0 / 0
0 / 0

최대 100만원 혜택! 탁탁몰, 10만 회원 달성 이벤트 진행
 조텍X탁탁몰
@zotac
26일전
조텍X탁탁몰
@zotac
26일전

마이크로닉스, 부산 ‘이터널 리턴’ 팝업서 현장 이벤트 진행
마이크로닉스
@micronics
1일전
마이크로닉스
@micronics
1일전


서린씨앤아이, 게일 PRISTINE V DDR5 메모리 출시
서린씨앤아이
@seorincni
1일전
서린씨앤아이
@seorincni
1일전




- 이벤트 l
- 체험단 모집 l
- 특가 이벤트 l
- 당첨/발표
- [체험단 모집] 맥스엘리트 850W 파워 체험단 모집
-
2026.01.21
 6
 4
- [특가 이벤트] 잘만, HPS800W 무선 헤드셋 및 HPS610 헤드셋 특가 및 포토리뷰 이벤트
-
2026.05.26
0
0
- [특가 이벤트] 크록스 스프링 페스타 3월 18일, 최대 6만원 추가 할인
-
2026.03.16
1
1
- [특가 이벤트] 3/3(화) 오후 8시, UP TO 50% + 라이브 단독 1만원 추가 할인
-
2026.03.02
0
0
- [특가 이벤트] 크록스 코리아 남성 BEST 클로그 5% 쿠폰 혜택
-
2026.02.26
0
1
- [당첨/발표] [발표] 댓글학원 우등생 TOP 5 발표
-
2026.09.29
15
13
- [당첨/발표] [발표] 댓글학원 우등생 TOP 5 발표
-
2026.07.22
10
6
- [당첨/발표] [발표] AI에이전트 미니PC지원 댓글이벤트 당첨자 발표
-
2026.04.06
6
3
- [당첨/발표] 맥스엘리트 850W 체험단 당첨자 발표
-
2026.02.02
3
2
- [당첨/발표] 1월 베스트 빌런 댓글러 이벤트 당첨자 발표
-
2026.02.02
5
3

- 종합
- 뉴스/정보
- 커뮤니티
- 질문/토론